เมื่อโรงงานมีข้อมูลอุณหภูมิ กระแส หรือการสั่นสะเทือนแล้ว คำถามถัดไปมักเป็น “ใช้ AI บอกก่อนเครื่องเสียได้ไหม” จุดเริ่มต้นที่ตรวจสอบได้ง่ายกว่าคือ รู้ว่าสภาพเครื่องเปลี่ยนไปจากช่วงทำงานปกติเมื่อใด และให้ช่างตรวจต่อได้อย่างไร
AIoT ในบริบทนี้คือการนำข้อมูลจากอุปกรณ์ IoT มาร่วมกับการวิเคราะห์ด้วย AI ส่วน Edge หมายถึงวางการประมวลผลบางส่วนใกล้แหล่งข้อมูล เช่น เกตเวย์หรือคอมพิวเตอร์หน้างาน ไม่ได้แปลว่าทุกขั้นตอนต้องทำโดยไม่ใช้เซิร์ฟเวอร์ส่วนกลาง
แยกการติดตามสภาพออกจากการทำนายวันเสีย
Condition Monitoring ติดตามค่าที่วัดได้และบริบทการทำงาน ส่วน anomaly detection ช่วยหาสัญญาณที่ต่างจากรูปแบบอ้างอิง ความผิดปกติอาจเกิดจากโหลด สูตรผลิต หรือเซนเซอร์หลวม ไม่ได้หมายถึงความเสียหายเสมอไป
การประมาณเวลาที่เหลือก่อนเสียต้องมีข้อมูลและนิยามเหตุการณ์ที่รองรับ หากมีเพียงข้อมูลช่วงปกติและประวัติซ่อมน้อย ควรระบุขอบเขตเป็นการเตือนเพื่อตรวจสอบ แทนการอ้างว่าจะคาดการณ์วันเสียได้
เลือกเครื่องที่มีโจทย์ซ่อมบำรุงชัดเจน
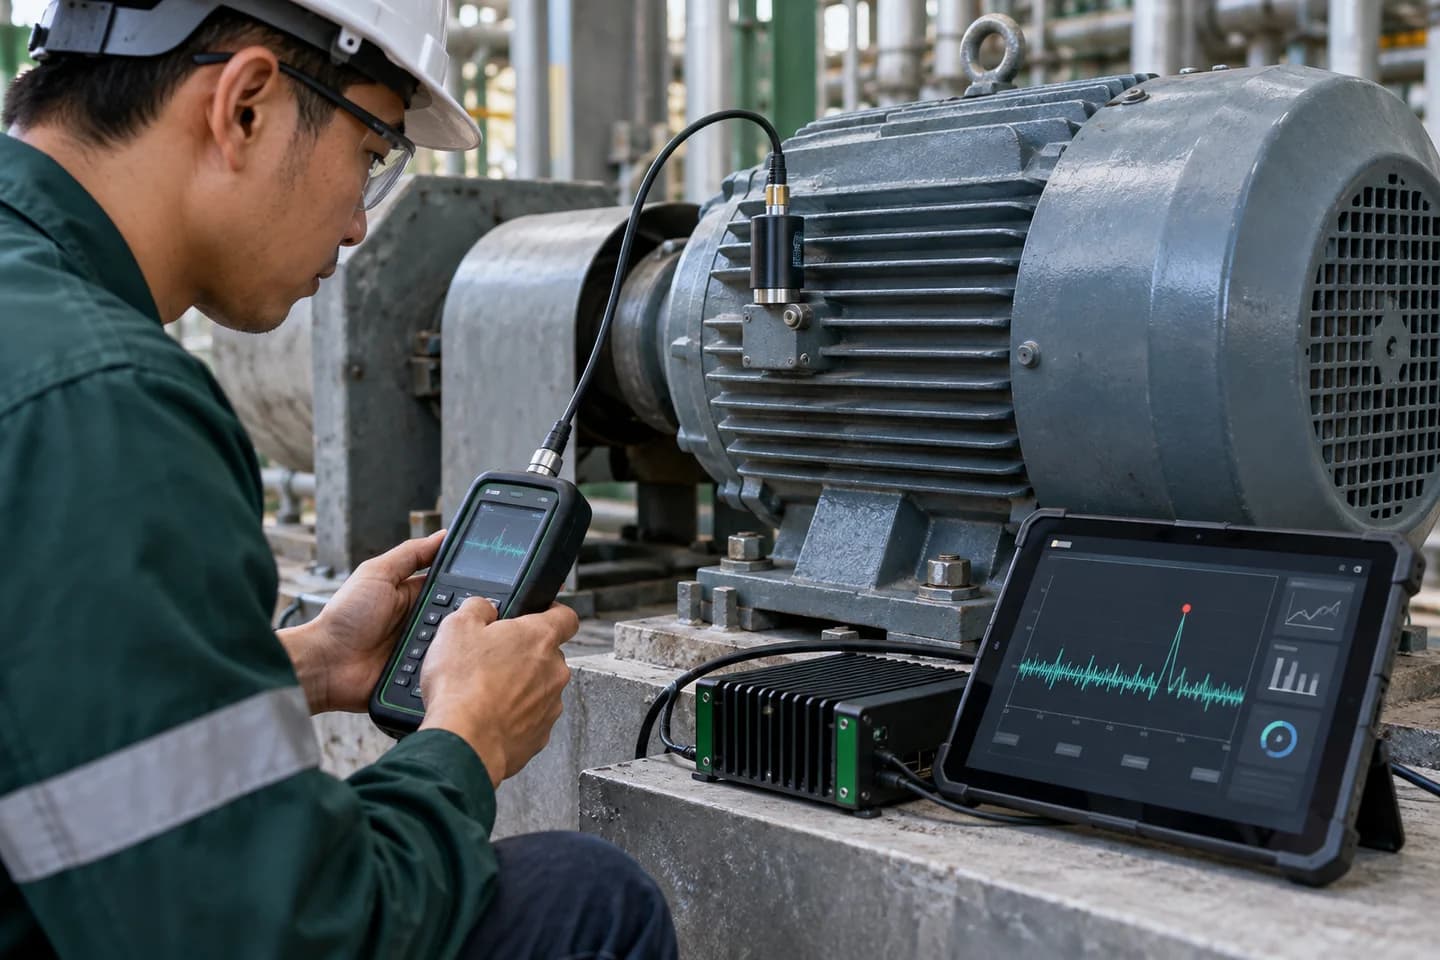
เริ่มจากเครื่องหนึ่งกลุ่มที่ช่างเข้าถึงได้ มีประวัติอาการ และรู้ผลกระทบเมื่อหยุด วางแผนจุดติดตั้งกับผู้รับผิดชอบเครื่อง โดยคำนึงถึงตำแหน่งยึดเซนเซอร์ ช่วงวัด ความถี่เก็บข้อมูล และสภาพแวดล้อม
| ข้อมูล | บริบทที่ควรเก็บคู่กัน | |---|---| | การสั่นสะเทือน | ความเร็วรอบ โหลด และจุดติดตั้ง | | อุณหภูมิ | อุณหภูมิแวดล้อมและช่วงอุ่นเครื่อง | | กระแสไฟ | สูตรผลิต สถานะเดินเบา และการเริ่มเดิน | | เหตุการณ์ซ่อม | อาการที่พบ งานที่ทำ และผลหลังซ่อม |
ไม่มีเซนเซอร์หรือโมเดลชุดเดียวที่เหมาะกับทุกอาการ ควรให้ข้อบกพร่องที่ต้องการติดตามเป็นตัวกำหนดข้อมูลที่จะเก็บ
วางบทบาท Edge และระบบส่วนกลาง
ข้อเสนอสำหรับโครงการนำร่องคือให้ Edge ตรวจความครบถ้วนของข้อมูล คำนวณคุณลักษณะที่จำเป็น และเก็บคิวระหว่างเครือข่ายขัดข้อง ส่วนระบบส่วนกลางรวมประวัติ แสดงแนวโน้ม และจัดการรุ่นโมเดล
OPC UA มีแนวคิดด้านการแลกเปลี่ยนข้อมูลและโมเดลข้อมูลสำหรับระบบอุตสาหกรรม อ่านบริบทได้จาก OPC Foundation: Overview and Concepts การเลือกวิธีเชื่อมต่อจริงยังต้องตรวจความสามารถและการตั้งค่าของอุปกรณ์แต่ละรุ่น
เมื่อส่งข้อมูลผ่านเกตเวย์ ควรคงรหัสเครื่อง เวลาแหล่งกำเนิด หน่วย และสถานะคุณภาพไว้ด้วย การเปลี่ยนหน่วยหรือเวลาที่ไม่ตรงกันอาจทำให้กราฟดูผิดปกติโดยที่เครื่องไม่ได้มีปัญหา
เริ่มเตือนแบบที่ช่างอธิบายต่อได้
แสดงแนวโน้มก่อนและหลังจุดแจ้งเตือน พร้อมโหลดและสถานะเครื่อง ให้ผู้รับแจ้งบันทึกว่าตรวจพบอะไรจริง กำหนดระยะพักการแจ้งเตือนและเจ้าของงาน เพื่อลดเหตุการณ์ซ้ำที่ยังไม่ได้ตรวจ
ให้ระบบแยกอย่างน้อยสามกรณี: ข้อมูลขาด, เซนเซอร์ผิดเงื่อนไข และสัญญาณเครื่องเปลี่ยนแปลง อย่าแสดงทุกกรณีเป็น “เครื่องใกล้เสีย”
วัดผลจากงานตรวจและประวัติซ่อม
ติดตามจำนวนแจ้งเตือนที่ช่างยืนยันได้ จำนวนแจ้งเตือนที่ไม่พบเหตุ เวลาที่ใช้ตรวจ และเหตุขัดข้องที่เกิดโดยไม่มีสัญญาณเตือน ประเมินแยกตามรุ่นเครื่องและสภาวะผลิต ไม่สรุปจากกราฟตัวอย่างช่วงสั้น
ระบบนำร่องควรเป็นข้อมูลช่วยตัดสินใจของทีมซ่อมบำรุงก่อน หากจะสั่งหยุดหรือเปลี่ยนค่าการทำงาน ต้องออกแบบร่วมกับระบบควบคุมและการประเมินหน้างานแยกต่างหาก
สำรวจ บริการ IoT, บริการ AI และ AIoT TH หรือ คุยเรื่องเครื่องและข้อมูลที่มีอยู่ เพื่อกำหนดขอบเขตนำร่องที่วัดผลได้