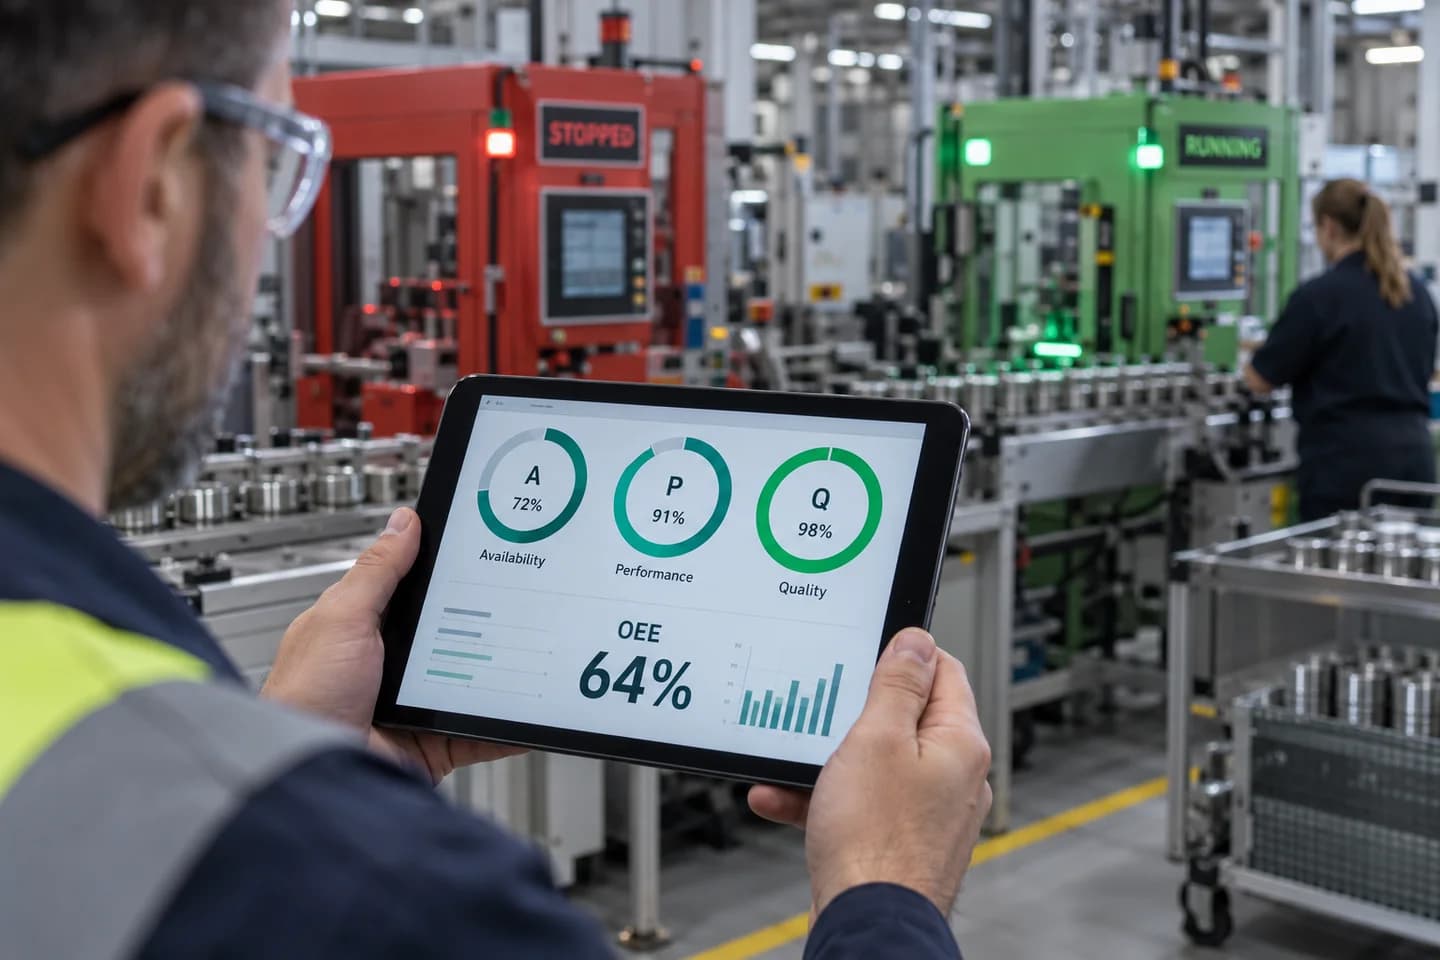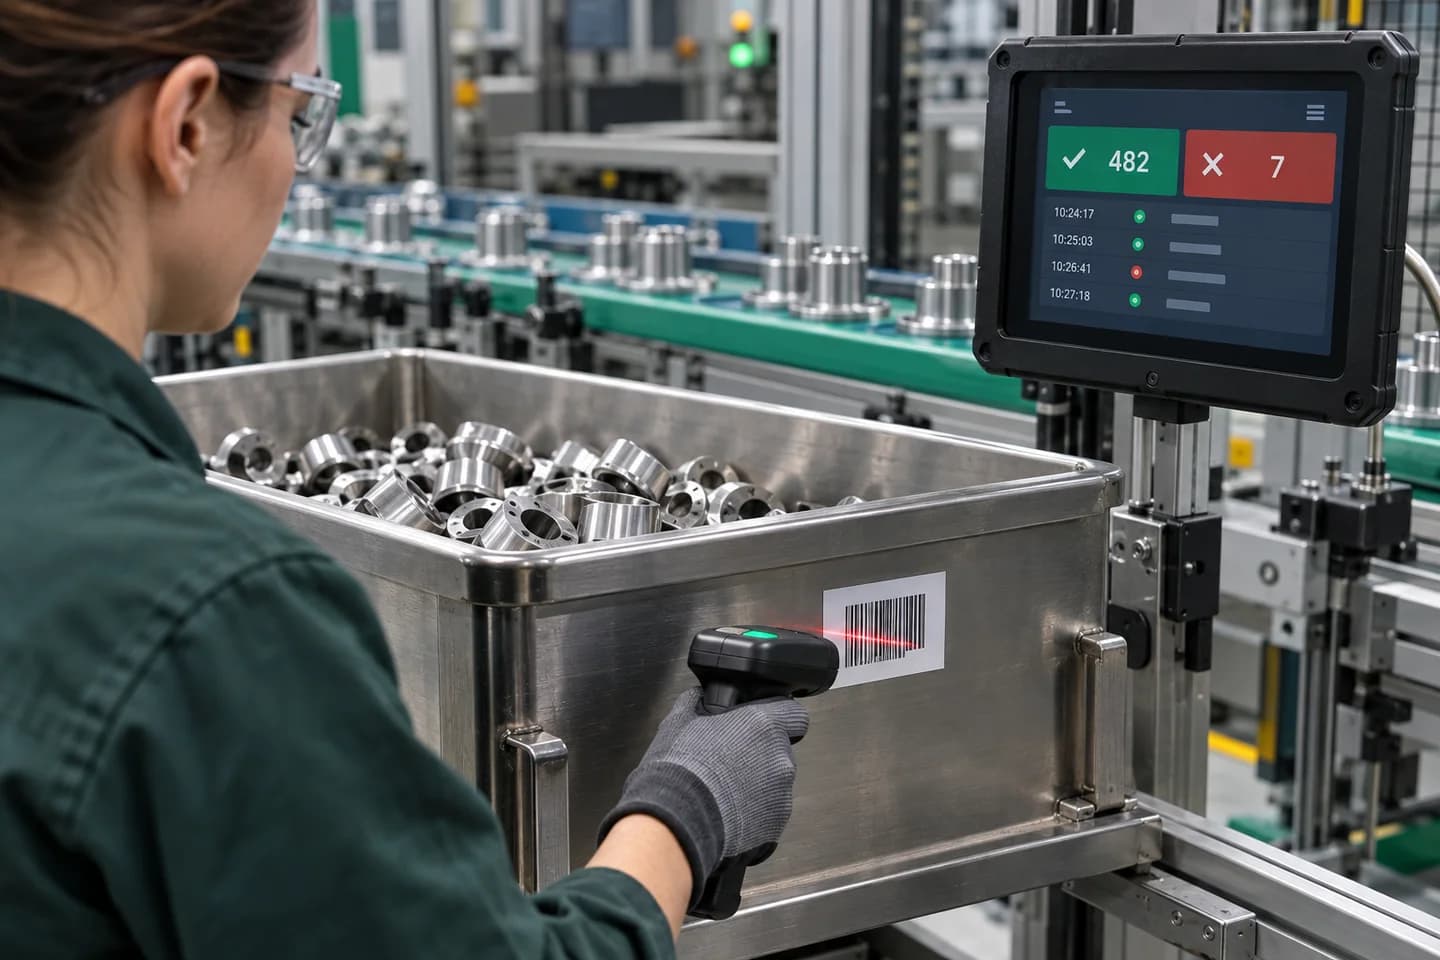
ระบบ AI, OEE, MES, APS — ทุกระบบในโรงงานต้องการ "ข้อมูล" และข้อมูลที่ดีต้องมาจาก ระบบบันทึกข้อมูลการผลิตที่ดี บทความนี้จะเล่าตั้งแต่ทำไมถึงต้องมี ไปจนถึงสถาปัตยกรรมที่ scale ได้
ทำไมถึงต้องมี Data Logging?
ปัญหาที่โรงงานไทยเจอบ่อย:
- ผู้ปฏิบัติงานบันทึกใน Excel → หาย, ผิด, ไม่ทันเวลา
- เครื่องจักรมี HMI แต่ไม่ export ข้อมูล
- รู้ว่าเดือนนี้ผลิตได้กี่ชิ้น แต่ไม่รู้ว่าแต่ละชั่วโมงเป็นยังไง
- เกิดปัญหาแล้วย้อนสาเหตุไม่ได้ (no traceability)
ระบบ Data Logging ที่ดีจะแก้ทุกข้อข้างบน และเปิดประตูให้:
- คำนวณ OEE real-time ทุกนาที
- ส่งข้อมูลเข้า MES สำหรับ traceability
- เก็บ training data ให้ AI/ML model
- ตรวจ pattern ของ failure ก่อนเกิดจริง
ข้อมูลอะไรที่โรงงานต้องเก็บ?
Tier 1 — Machine Data (เก็บก่อน)
- Status: Run / Idle / Down / Maintenance
- Counter: Good count, Reject count
- Cycle time ต่อชิ้น
- Speed ปัจจุบัน vs ออกแบบ
- Alarm/Error code จาก PLC
Tier 2 — Process Data
- Temperature, Pressure, Flow ของแต่ละ stage
- Power consumption ของเครื่อง
- Vibration ของมอเตอร์ (predictive maintenance)
- Tool wear เช่น drill bit, แม่พิมพ์
Tier 3 — Product Data
- Lot number + วันที่/เวลาผลิต
- Quality measurement (dimension, weight, defect)
- Operator ID + ผู้ตรวจสอบ
- Raw material lot (เพื่อ traceability)
Tier 4 — Environment Data
- Temperature/humidity ของห้อง
- Air quality (สำหรับ cleanroom)
- Energy consumption รวมโรงงาน
สถาปัตยกรรมที่ใช้กันในอุตสาหกรรม
[เครื่องจักร] → [PLC/Sensor] → [Edge Gateway] → [Message Broker]
                                    ↓                ↓
                           [Local cache]      [Time-series DB]
                                                     ↓
                                              [Analytics + Dashboard]
                                                     ↓
                                           [AI/ML + Alert + Reports]
Layer 1: Field Layer (เครื่องจักร)
- PLC (Siemens, Mitsubishi, Allen Bradley)
- Sensors (temperature, pressure, vibration)
- HMI (อ่านข้อมูลจาก operator)
Layer 2: Edge Layer (Gateway)
- Industrial PC หรือ Raspberry Pi
- Buffer ข้อมูล เผื่อ network ขาด
- Pre-processing เช่น filter noise, calculate moving average
- Protocol translation OPC UA → MQTT
Layer 3: Transport Layer
- MQTT (lightweight, real-time) สำหรับ telemetry
- OPC UA สำหรับเครื่องจักรอุตสาหกรรม
- REST API สำหรับ batch/config
- Apache Kafka ถ้าต้องการ scale ใหญ่
Layer 4: Storage Layer
- Time-series DB สำหรับ telemetry
- Relational DB สำหรับ master data + transaction
- Object storage (S3) สำหรับภาพ/ไฟล์
Layer 5: Application Layer
- Dashboard (Grafana, custom)
- AI/ML pipelines
- Alert/Notification — ส่งผ่าน Email Server หรือ LINE Notify
หมายเหตุ: ถ้าระบบ Data Logging ของคุณรันบน on-premise พิจารณาย้ายขึ้น VPS/Cloud Server เพื่อ uptime และ disaster recovery ที่ดีกว่า
เลือก Time-series Database ยังไง?
| Database | จุดเด่น | จุดอ่อน | เหมาะกับ | |----------|---------|---------|----------| | InfluxDB | ติดตั้งง่าย, schema-less, ecosystem ดี | scale ยากเมื่อใหญ่มาก | SME, Pilot | | TimescaleDB | SQL-based, scale ดี, JOIN ได้ | setup ซับซ้อนกว่า | SME-Enterprise | | QuestDB | เร็วมาก, low memory | community เล็ก | High-throughput | | Prometheus | สำหรับ monitoring โดยเฉพาะ | retention สั้น | Infrastructure metrics | | Apache IoTDB | optimize สำหรับ IoT, compression สูง | ใหม่, doc น้อย | Large-scale IoT |
คำแนะนำสำหรับโรงงานไทย: เริ่มจาก InfluxDB หรือ TimescaleDB — ใช้ฟรี, ติดตั้งได้ในวันเดียว, InfluxDB มี Telegraf agent เก็บข้อมูลอัตโนมัติ ส่วน TimescaleDB เหมาะถ้าทีมถนัด SQL/PostgreSQL อยู่แล้ว
InfluxDB 1.x, 2.x และ 3.x มีภาษา query และฟีเจอร์ต่างกันมาก ก่อนเลือกให้เช็คว่ารุ่น open-source ที่จะใช้รองรับการเก็บข้อมูลระยะยาวและ downsample แบบที่ต้องการ
Data Retention Strategy
ข้อมูลโรงงานเก็บ 100% ตลอดไปจะเปลือง storage มาก ใช้ tiered retention:
| ความละเอียด | ระยะเวลาเก็บ | ใช้ทำอะไร | |-------------|--------------|-----------| | 1 วินาที (raw) | 7-30 วัน | Debug, troubleshooting | | 1 นาที (downsample) | 1 ปี | Trend analysis, OEE history | | 1 ชั่วโมง (downsample) | 5+ ปี | Long-term reporting, audit |
การทำ downsample อัตโนมัติ: InfluxDB 1.x ใช้ continuous query, InfluxDB 2.x ใช้ Tasks, TimescaleDB ใช้ continuous aggregates — ตั้งครั้งเดียวแล้วระบบย่อยข้อมูลให้เอง
ความเสี่ยงและวิธีป้องกัน
❌ Network ขาด → ข้อมูลหาย
แก้: Edge gateway ต้อง buffer local อย่างน้อย 24 ชั่วโมง
❌ Disk เต็ม → DB หยุด
แก้: ตั้ง alert ที่ 80%, มี retention policy ชัดเจน
❌ ข้อมูลผิด timezone
แก้: ทุก timestamp เก็บเป็น UTC, แสดงผลเป็น local
❌ Security: เปิด port ออก internet
แก้: ใช้ VPN หรือ private network, MQTT TLS + auth
❌ ไม่มี backup
แก้: Daily backup ไป cloud storage (cost ต่ำมาก)
Use Case จริง: โรงงานชิ้นส่วนรถยนต์
ก่อนมีระบบ:
- บันทึก downtime ในใบกระดาษ
- รู้ OEE หลังปิดเดือน
- หาสาเหตุของเสียใช้เวลา 1-2 วัน
หลังติดตั้ง Data Logging (InfluxDB + 30 sensor + 1 gateway):
- OEE real-time ใน Grafana
- Alert ผ่าน LINE เมื่อเครื่องหยุด > 5 นาที
- Trace ของเสียกลับไปหา root cause ใน 5 นาที
- ROI 14 เดือน จากลด downtime 8%
สรุป
Data Logging คือ infrastructure ที่ invisible แต่จำเป็น ของ Smart Factory
ลงทุนกับ data layer ก่อน — ระบบที่อยู่บน (OEE, MES, APS, AI) จะทำงานได้ดี ลงทุนกับ AI/ML ก่อน data — ทุกอย่างจะ garbage in garbage out
ถ้ากำลังออกแบบระบบเก็บข้อมูลในโรงงาน ทีม ไนท์เดย์ เทคโนโลยี ติดตั้งได้ทั้ง stack แบบ open-source (InfluxDB + Grafana + MQTT) และระบบ enterprise — ติดต่อเรา เพื่อพูดคุยรายละเอียด